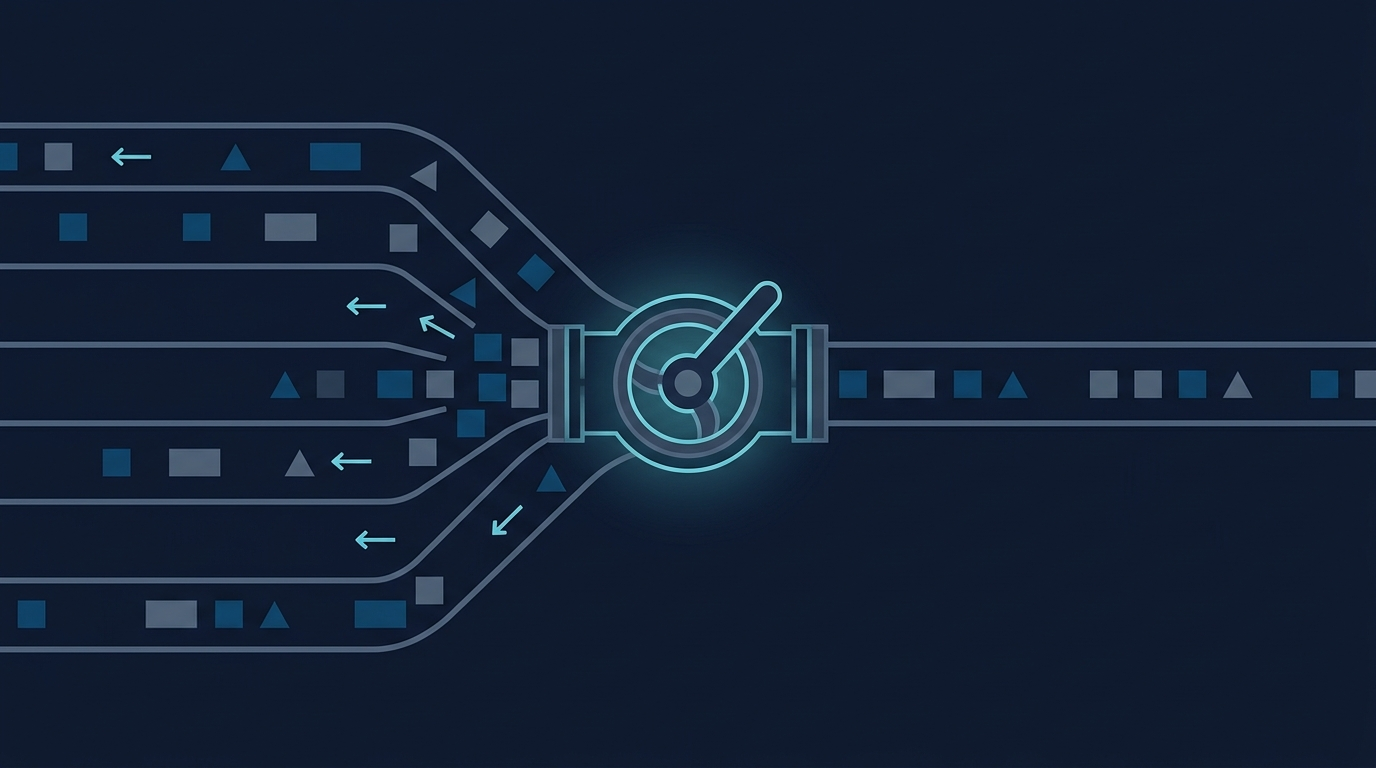
Todo sistema con colas tiene un momento en que la producción supera a la capacidad de consumo. La diferencia entre un sistema maduro y uno frágil no es si ese momento llega, sino qué pasa cuando llega. Sin backpressure, la sobrecarga se convierte en memoria infinita, latencias en cascada y un reinicio que borra el problema (y los datos). Con backpressure, el sistema dice "no" de forma controlada antes de colapsar.
El problema: la cola que oculta la sobrecarga
Una cola es útil para absorber picos, pero también es el mejor mecanismo para esconder un problema de capacidad. Si un productor emite 1.000 eventos por segundo y el consumidor procesa 800, la cola crece 200 eventos por segundo de forma indefinida. Mientras nadie mire la profundidad de la cola, todo parece funcionar: los tests pasan, el dashboard está verde y las alertas duermen. Tres horas después, la memoria se agota, los mensajes expiran o la latencia de procesamiento es tan alta que el resultado ya no sirve.
La lección central es simple: una cola sin límite no es un buffer, es un aplazamiento del fallo. El backpressure existe para convertir ese aplazamiento en una señal explícita y manejable.
Qué es el backpressure realmente
Backpressure es la propagación de la señal "estoy saturado" desde el consumidor hacia el productor, para que este reduzca su ritmo. No es una técnica única, sino una familia de decisiones combinadas:
- Detección de sobrecarga: métricas de profundidad de cola, latencia de procesamiento, uso de recursos o canaries que indican estrés.
- Decisión sobre el exceso: rechazar, degradar, muestrear o enrutar el trabajo sobrante.
- Propagación aguas arriba: el productor debe enterarse y ajustar su tasa, no seguir empujando.
Patrones prácticos de implementación
1. Límites explícitos en las colas
Toda cola debe tener un máximo definido. Al alcanzarlo, el comportamiento debe ser deliberado: rechazar la publicación, sobrescribir los datos más antiguos o activar un modo degradado. Un límite de 10.000 mensajes con política de rechazo explícita vale más que una cola "infinita" que solo pospone el incidente.
2. Load shedding en el borde
Antes de aceptar trabajo que el sistema no puede procesar a tiempo, es mejor rechazarlo temprano con una respuesta clara. En APIs HTTP, esto significa devolver un estado de sobrecarga cuando la saturación es detectable. Un rechazo en milisegundos es más barato para todos que un timeout a los 30 segundos.
3. Rate limiting en la fuente
El backpressure es más eficaz cuando se complementa con control de tasa en el origen. Algoritmos como token bucket o leaky bucket permiten suavizar picos o tolerar ráfagas según el caso. Un ejemplo genérico de configuración:
rate_limit: { capacity: 500, refill_rate: 100/s } // 500 de ráfaga, 100 req/s sostenidas 4. Timeouts y cancelación aguas abajo
Un consumidor lento debe poder cancelar el trabajo que ya no vale la pena terminar. Timeouts por etapa, con presupuestos de latencia propagados en las cabeceras de la petición, evitan que un componente lento consuma recursos de todo el árbol de llamadas.
5. Degradación controlada
Bajo presión, el sistema puede reducir la fidelidad del trabajo: muestrear eventos, desactivar enriquecimientos no esenciales o cambiar a un modo por lotes. El objetivo es mantener el servicio esencial en lugar de intentar mantener todo y perder todo.
Errores comunes
- Reintentos sin límite: cuando el productor rechazado reintenta de inmediato, el backpressure se transforma en un ataque a uno mismo. Siempre con backoff exponencial y jitter.
- Alertar por CPU y no por cola: la profundidad de la cola y la edad del mensaje más antiguo suelen ser señales más tempranas que el consumo de recursos.
- Buffering en cada capa: buffers "por si acaso" en cada componente multiplican la latencia y ocultan el cuello de botella real.
- Backpressure solo técnico: si el equipo de producto no sabe que a partir de cierto volumen se degradará el servicio, la decisión se tomará en medio del incidente, no en el diseño.
Checklist de diseño
- ¿Toda cola tiene límite máximo y política de desbordamiento definida?
- ¿El productor reduce su tasa al recibir rechazo, o solo reintenta?
- ¿Existen presupuestos de latencia propagados entre servicios?
- ¿Se monitoriza la profundidad de cola y la antigüedad del mensaje más antiguo?
- ¿El modo degradado está probado, no solo documentado?
El backpressure es una de esas inversiones invisibles: nadie lo nota cuando funciona, pero define la diferencia entre un pico de tráfico y una página de incidente. Diseña el "no" antes de necesitarlo.